INSIGHTS / AI 마케팅
AI 크롤러란 무엇일까? robots.txt로 열 곳과 막을 곳을 정하는 법
2026. 10. 29.최원빈
Index
2화에서 출처로 인용됐던 A스튜디오 대표가 홈페이지를 새로 만들어 열었다고 해봅시다. 그런데 몇 주가 지나도 ChatGPT 검색 답변에 새 사이트가 나오지 않았습니다. 원인을 찾아보니 개발하는 동안 검색엔진을 막으려고 써둔 robots.txt 한 줄이 그대로 배포돼 있었습니다.
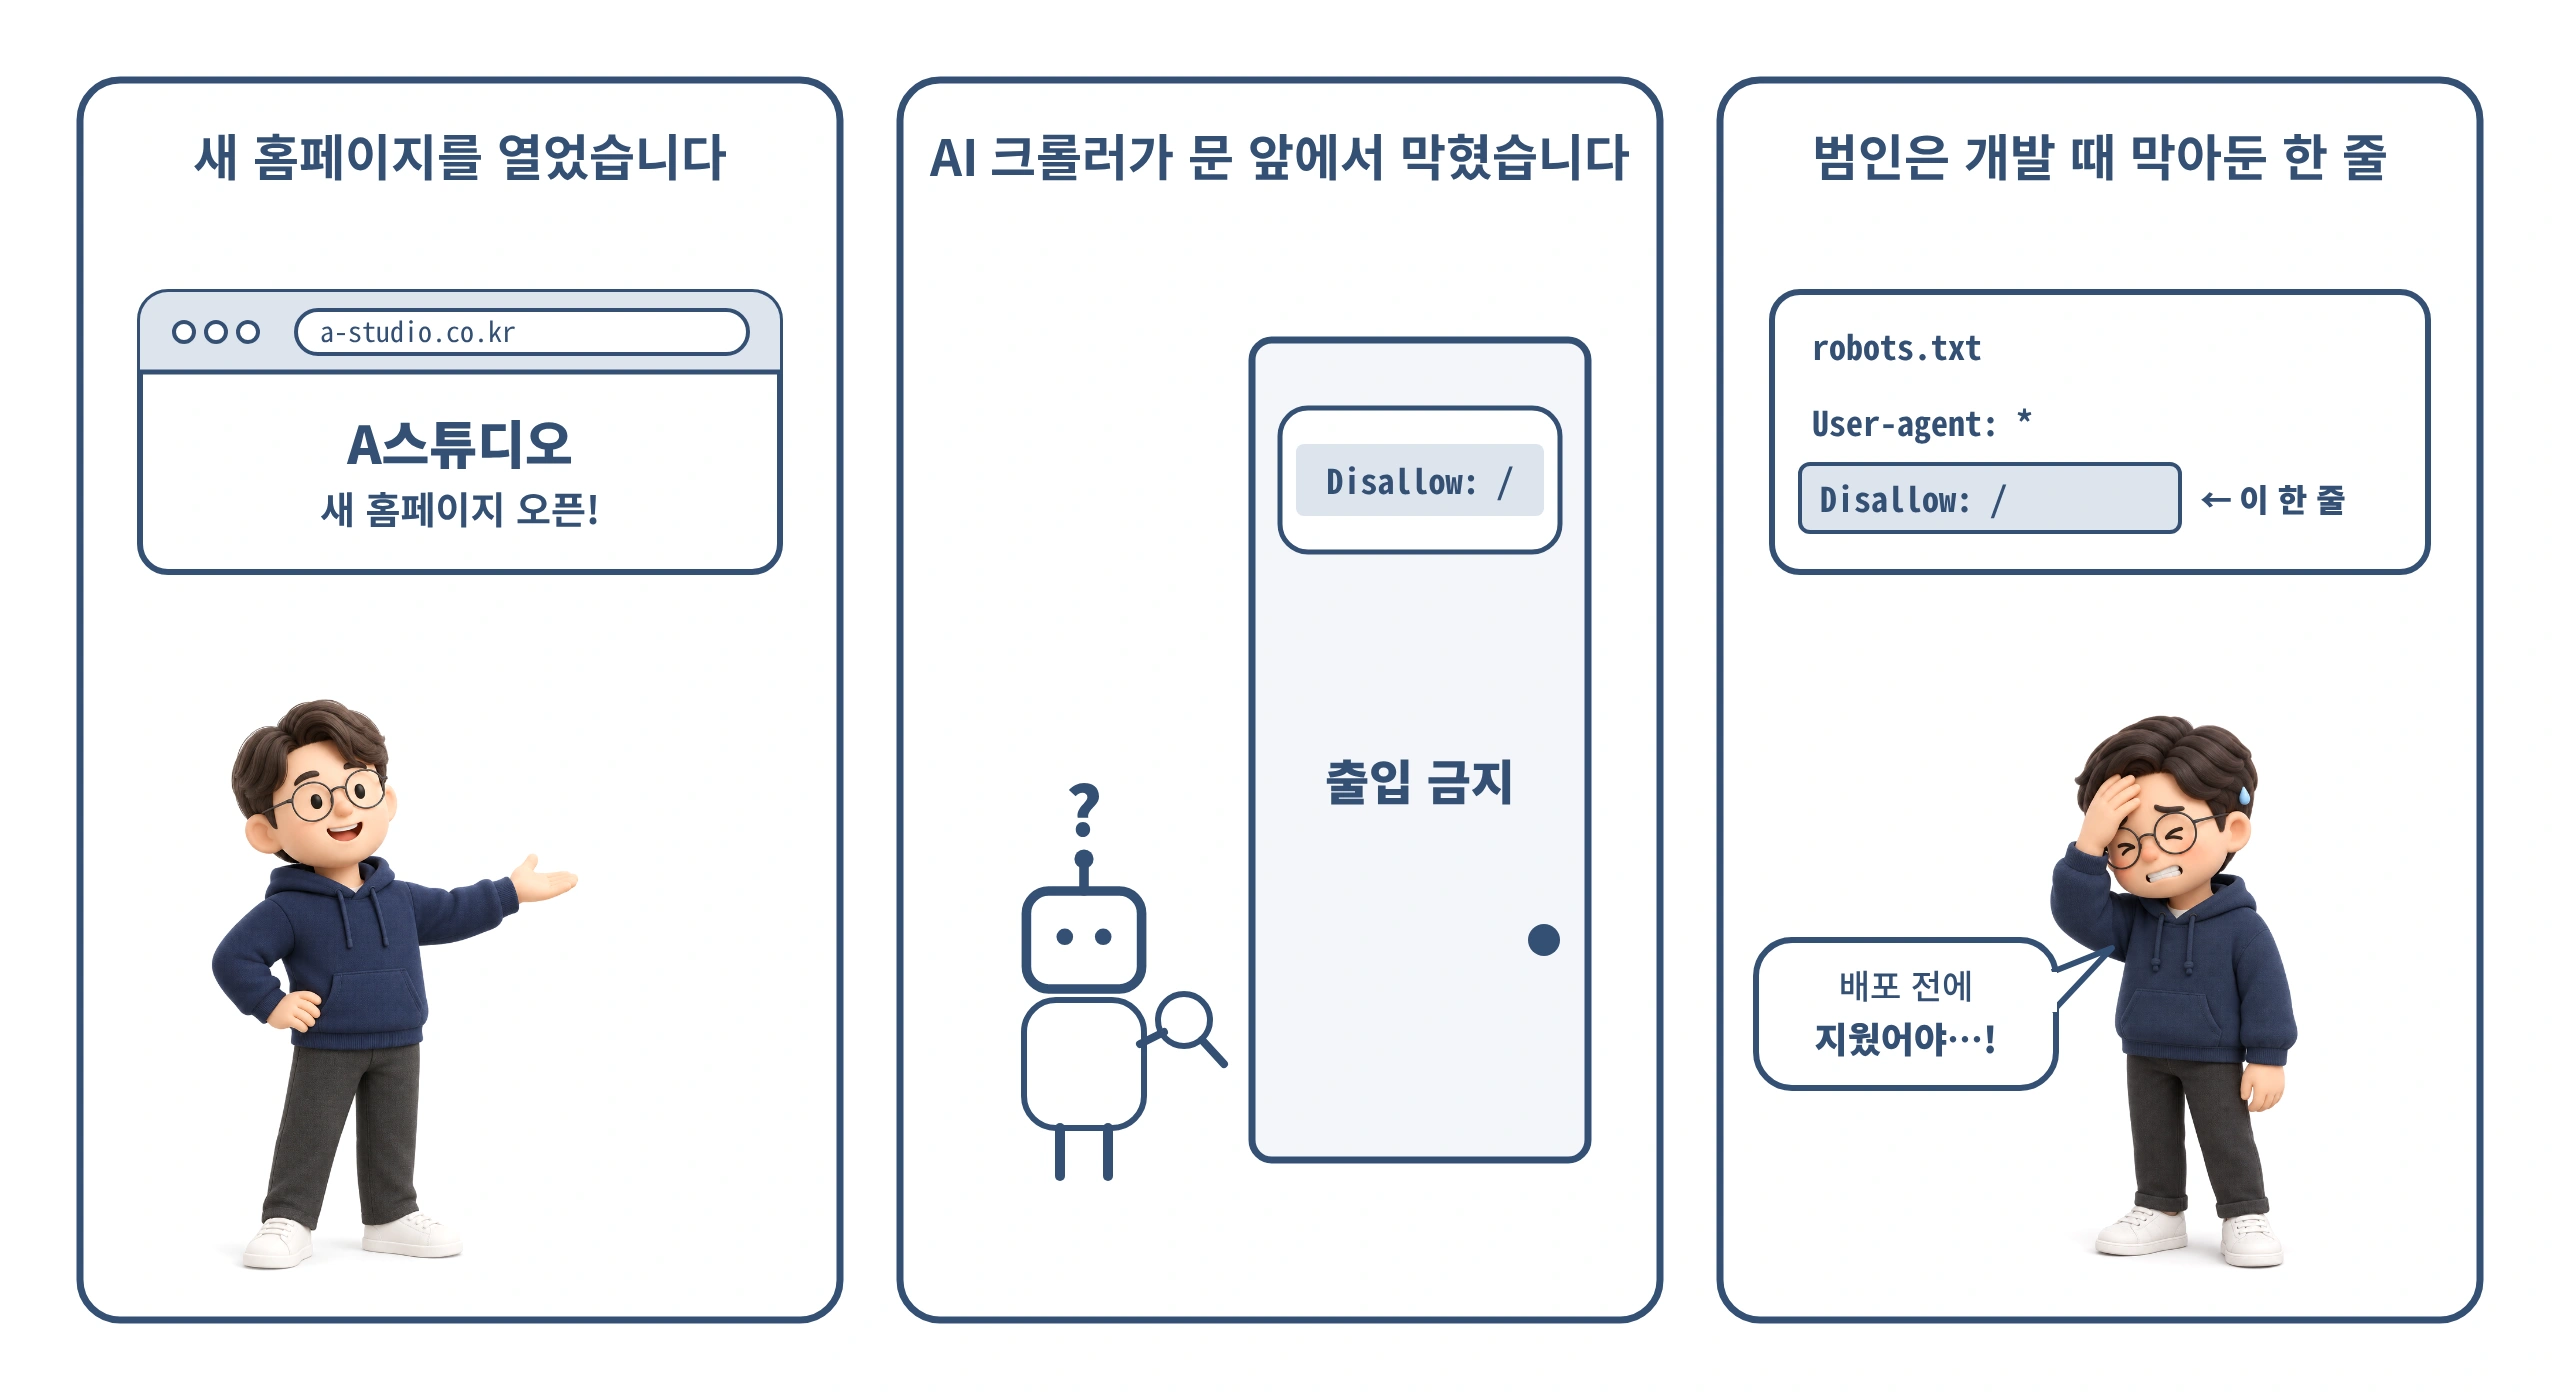
아무리 좋은 글도, 검색용 크롤러의 접근을 막으면 AI 검색에서 발견되고 출처로 활용되는 데 제약이 생깁니다.
2화에서 AI 검색은 답을 쓰기 전에 웹을 먼저 검색하고 읽는다고 했습니다. 그렇다면 AI가 펼쳐보는 그 책은 누가 모을까요? 답은 크롤러입니다. AI 회사들은 크롤러라는 프로그램으로 웹페이지를 모으고, 우리 사이트는 robots.txt라는 파일로 어떤 크롤러를 들일지 정합니다.
아래에 AI 크롤러의 종류, 실제로 사이트들이 어떤 크롤러를 막고 있는지, robots.txt로 검색은 열고 학습만 막는 방법을 정리했습니다.
1. 크롤러란 무엇인가요?
크롤러는 웹페이지를 자동으로 방문해 내용을 읽고 저장하는 프로그램입니다. 봇(bot)이나 스파이더(spider)라고도 부릅니다.
도서관에 비유하면 크롤러는 새로 나온 책을 찾아다니며 도서관 목록에 등록하는 사서입니다. 사서가 들르지 않은 책은 목록에 없고, 목록에 없는 책은 아무리 좋아도 추천될 수 없습니다.
구글의 Googlebot이 대표적인 검색 크롤러입니다. 지금은 OpenAI, Perplexity, Anthropic 같은 AI 회사들도 각자의 크롤러를 운영합니다.
2. AI 크롤러는 어떤 종류가 있나요?
AI 크롤러는 목적에 따라 검색용, 학습용, 사용자 요청형으로 나뉩니다. 각 회사의 공식 문서를 보면 이름도 목적별로 따로 있습니다.
① 검색용 크롤러
AI 검색 답변에 사이트를 보여주고 출처로 링크하기 위해 페이지를 모읍니다. AI 검색에서 출처로 보이고 싶다면 열어두는 것이 기본입니다.
② 학습용 크롤러
AI 모델을 학습시키는 데 쓰일 수 있는 자료를 모읍니다. 검색 노출과는 따로 설정할 수 있습니다.
③ 사용자 요청형 방문
사용자가 AI에게 질문하거나 링크를 주면, 그 답을 위해 AI가 해당 페이지를 그때그때 방문합니다. 자동으로 웹을 돌아다니는 크롤링과는 다릅니다.
회사 | 검색용 | 학습용 | 사용자 요청형 |
|---|---|---|---|
OpenAI (ChatGPT) | OAI-SearchBot | GPTBot | ChatGPT-User |
Perplexity | PerplexityBot | 학습용으로 쓰지 않는다고 밝힘 | Perplexity-User |
Anthropic (Claude) | Claude-SearchBot | ClaudeBot | Claude-User |
Googlebot | Google-Extended (학습·일부 Gemini 근거 활용 제어용 이름) | — |
OpenAI는 OAI-SearchBot을 막은 사이트는 ChatGPT 검색 답변에 나오지 않고, GPTBot을 막는 것은 콘텐츠를 모델 학습에 쓰지 말라는 표시라고 안내합니다. 두 설정은 서로 독립적입니다.
Perplexity는 PerplexityBot을 검색 결과에 사이트를 보여주고 링크하는 데만 쓰고, AI 모델 학습용 수집에는 쓰지 않는다고 밝혔습니다. Anthropic은 ClaudeBot을 막는 것을 사이트의 향후 자료를 학습 데이터에서 제외해 달라는 신호라고 설명합니다. 이미 학습된 내용을 지우는 조치로 설명하지는 않습니다. Claude-SearchBot을 막으면 검색 결과에서 사이트의 노출과 정확성이 떨어질 수 있다고 안내합니다.
구글의 Google-Extended는 조금 다릅니다. 따로 방문하는 크롤러가 아니라, 구글이 모은 콘텐츠를 향후 Gemini 모델의 학습과 Gemini 앱·일부 Vertex AI 기능의 답변 근거(grounding)로 써도 되는지 정하는 제어용 이름입니다. 구글은 Google-Extended가 구글 검색 노출이나 순위에는 영향을 주지 않는다고 밝혔습니다. 다만 구글 검색과 Gemini의 답변 근거 활용은 별개이므로 구분해서 봐야 합니다.
3. 다른 사이트들은 AI 크롤러를 막고 있나요?
이름을 직접 지정해 막은 사이트는 많지 않고, 그중에서는 GPTBot 등 학습 자료 수집과 관련된 봇의 비율이 상대적으로 높았습니다. SEO 도구 회사 Ahrefs가 약 1억 4천만 개 사이트의 robots.txt를 분석해, 크롤러 이름을 직접 지정해 막은 비율을 봤습니다. 방화벽이나 IP 차단은 포함하지 않은 조사입니다.
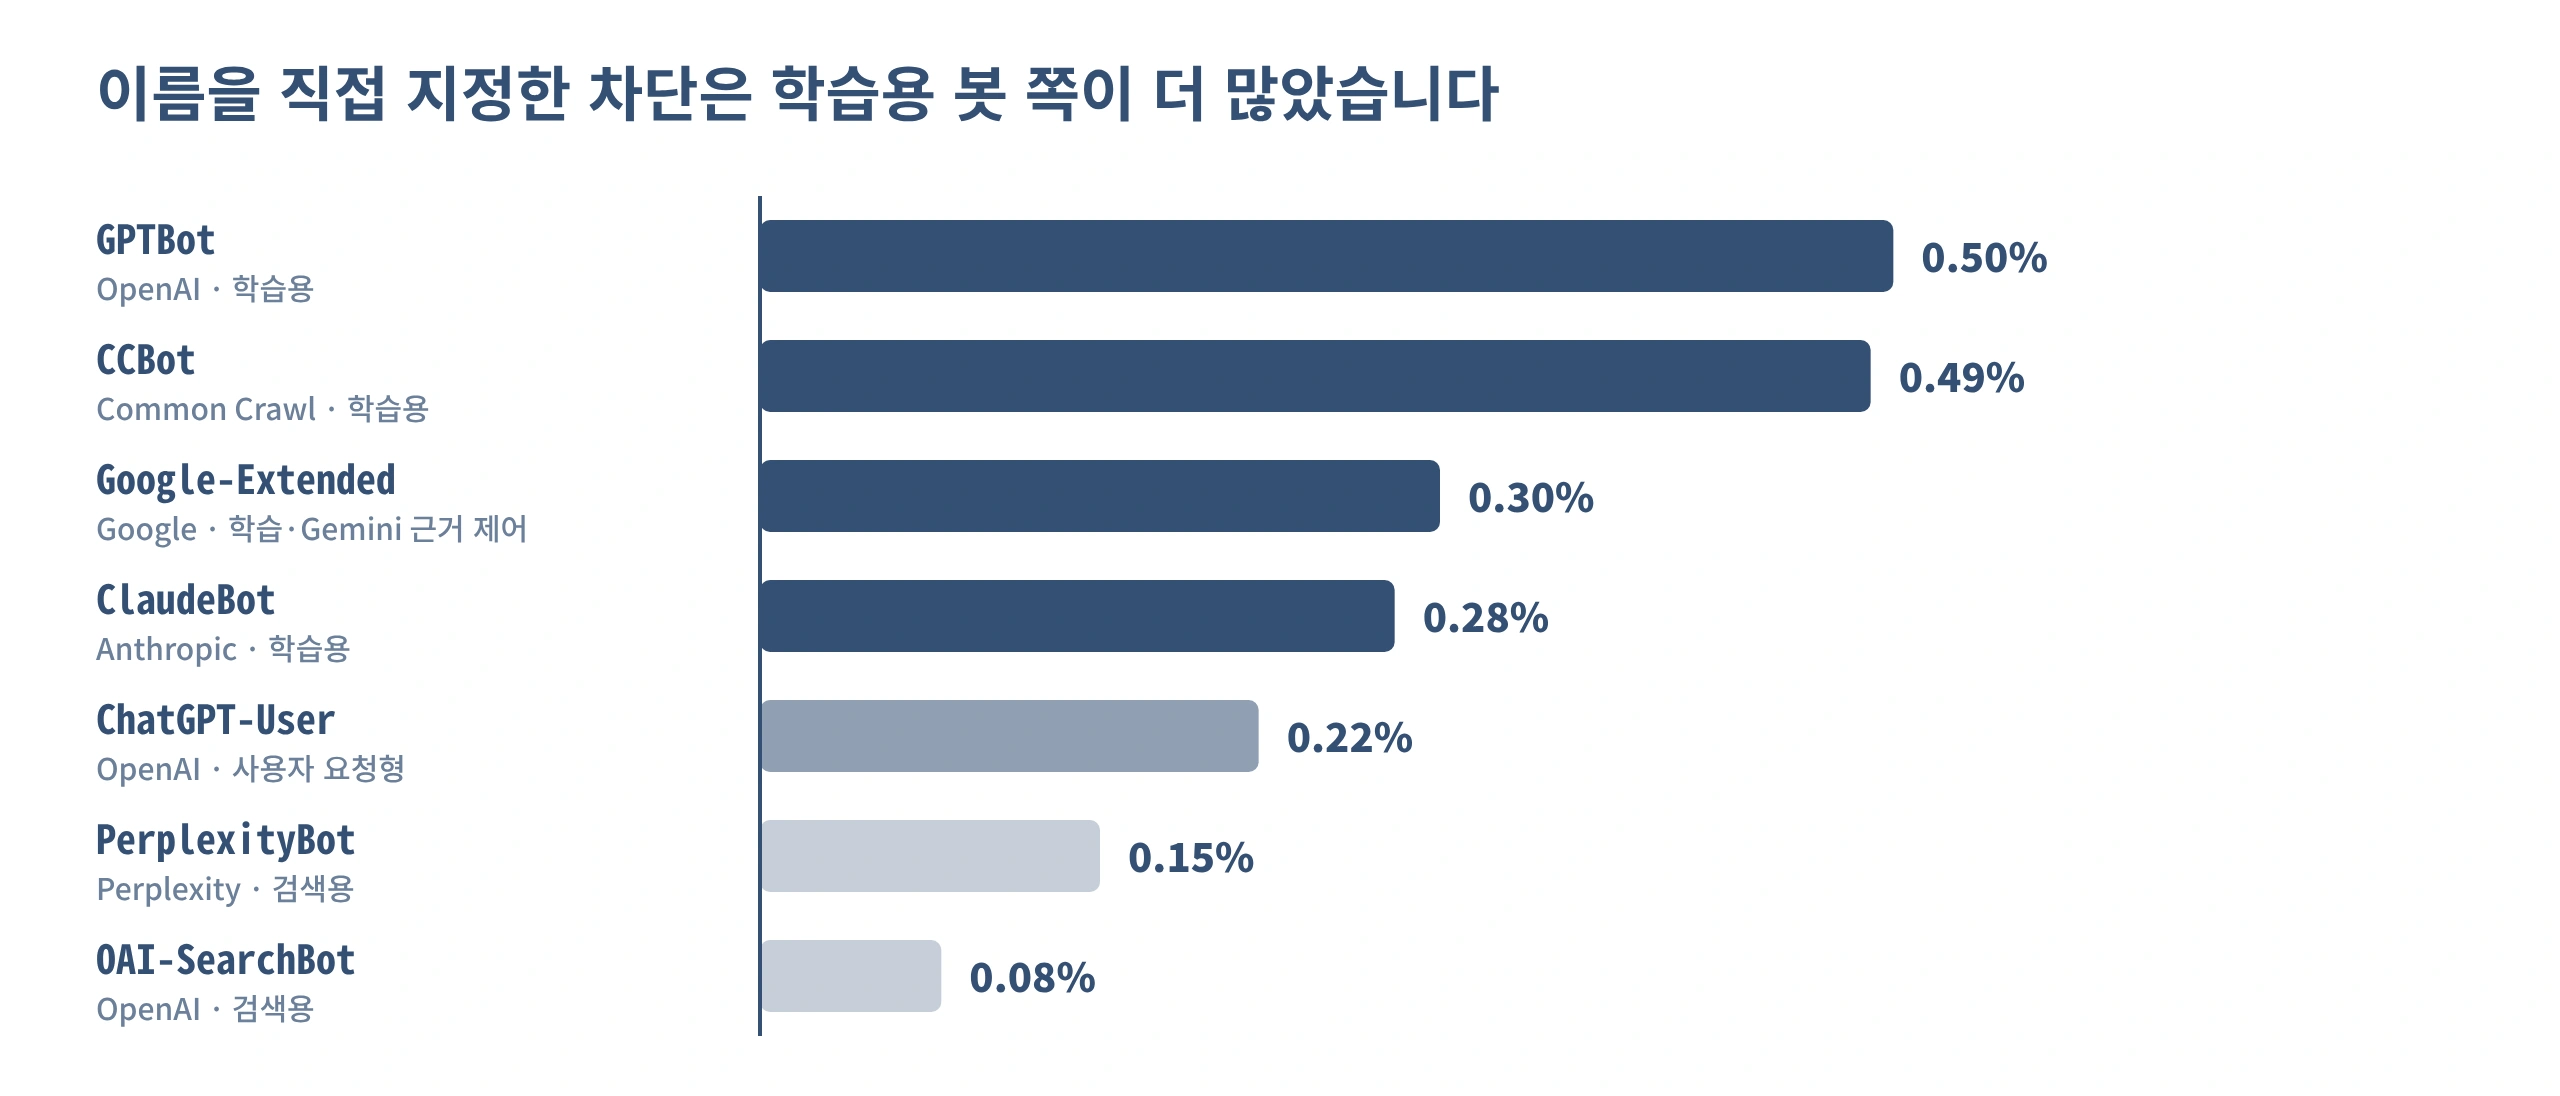
Ahrefs · 약 1억 4천만 사이트의 대표 robots.txt 기준 (2025년 5월 발표)
더 눈여겨볼 숫자는 따로 있습니다. 같은 분석에서 OAI-SearchBot이 어떤 식으로든 막혀 있는 사이트는 5.54%였지만, 이름을 직접 지정해 막은 곳은 0.08%뿐이었습니다. 나머지는 전체 크롤러에 적용되는 포괄적인 차단 규칙 등에 해당한 경우입니다. 이 조사에서는 OAI-SearchBot을 직접 지정한 차단보다, 전체 크롤러 등에 적용되는 포괄적인 차단이 훨씬 많았습니다.
다만 이 조사는 robots.txt 규칙만 본 것이라, 운영자가 의도해서 막았는지나 실제 AI 검색에서 빠졌는지는 알 수 없습니다. 그래도 이름을 직접 막지 않았더라도 공통 차단 규칙의 영향을 받을 수 있으니, 우리 사이트도 확인해볼 필요가 있습니다.
4. robots.txt로 어떻게 열고 막나요?
robots.txt는 크롤러에게 사이트의 어디까지 들어와도 되는지 알려주는 안내문 파일입니다. 보통 우리도메인/robots.txt 주소에 둡니다.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /User-agent는 어떤 크롤러에게 하는 말인지, Disallow: /는 사이트 전체를 막는다는 뜻, Allow: /는 전체를 허용한다는 뜻입니다. 이렇게 쓰면 크롤러마다 결과가 이렇게 달라집니다.
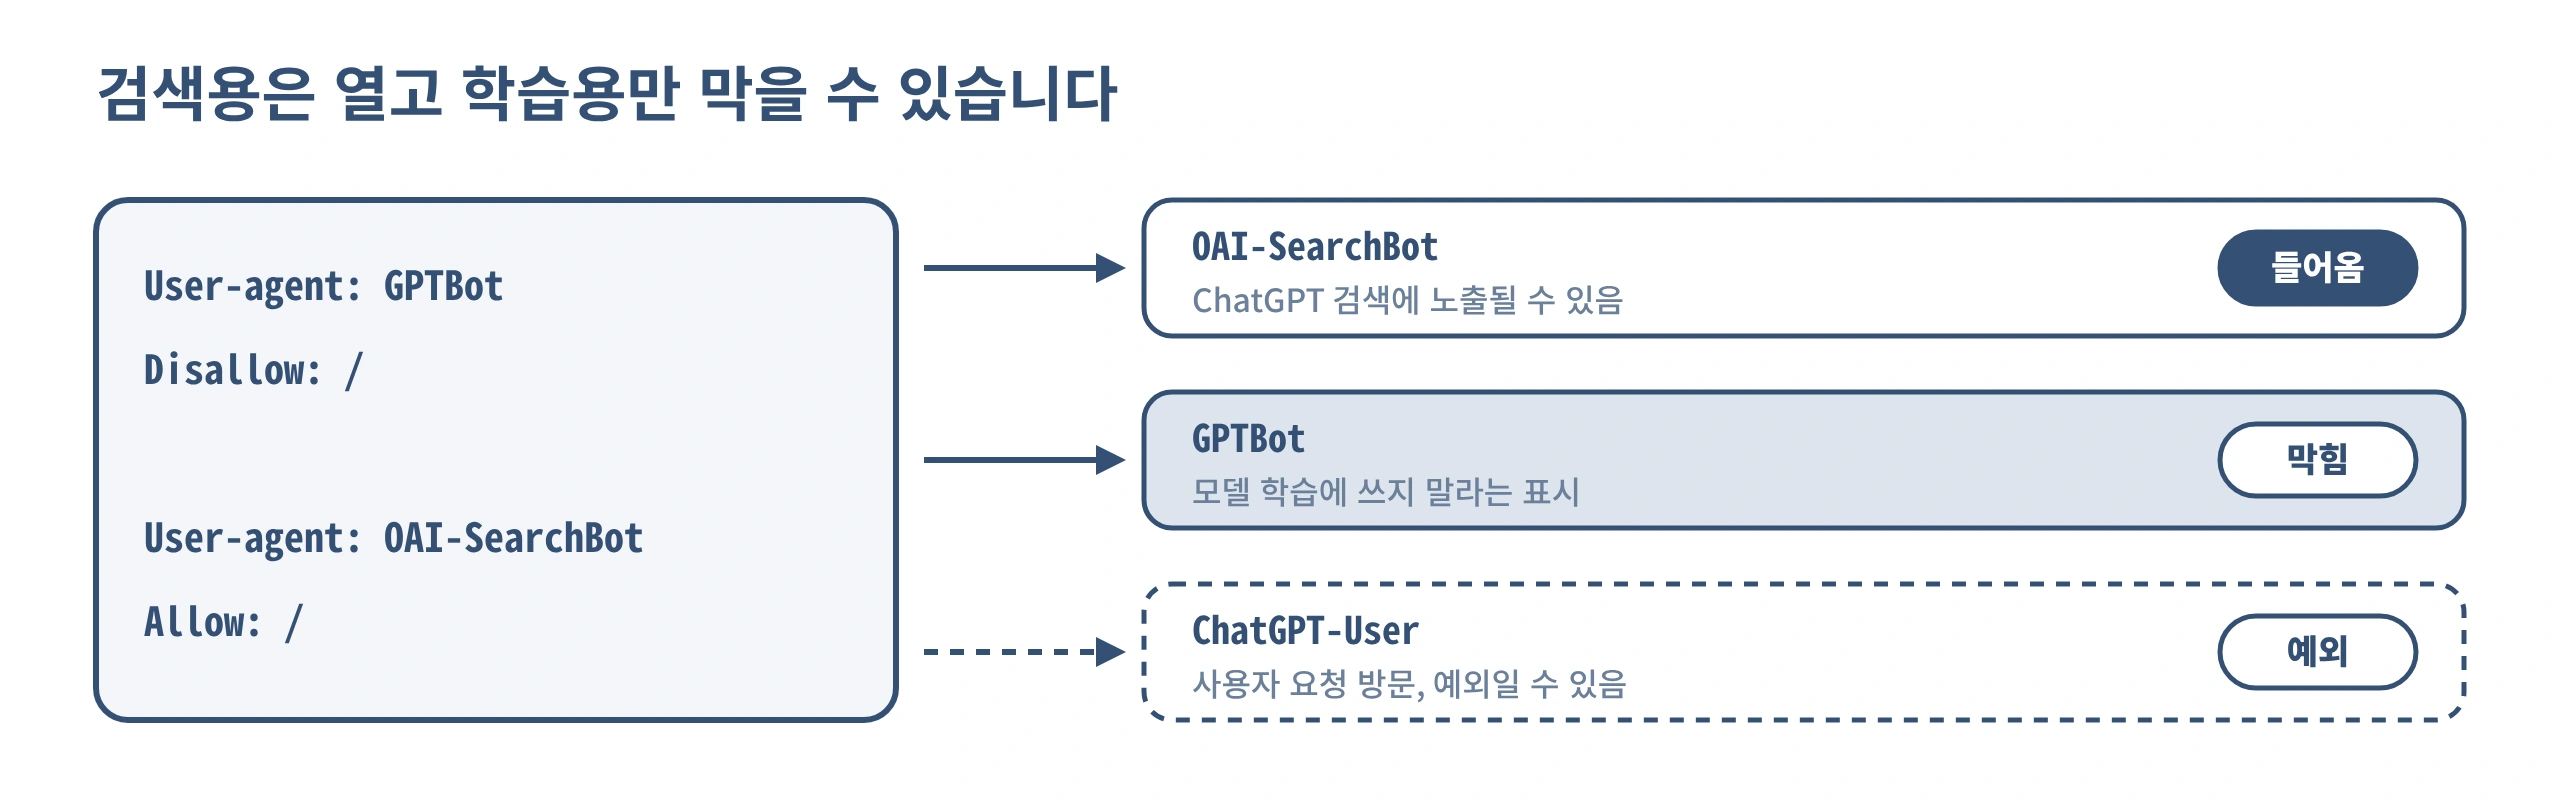
검색용은 열고 학습용만 막는 robots.txt 설정 (OpenAI 크롤러 기준)
OpenAI의 GPTBot을 통한 학습용 수집은 거부하면서, ChatGPT 검색용 수집은 허용하는 설정입니다. OpenAI가 두 크롤러를 독립적으로 설정할 수 있다고 밝혔기 때문에 가능한 조합입니다. 다만 둘 다 허용하면 한 번 수집한 결과를 두 목적에 함께 쓸 수 있다고도 안내합니다.
5. robots.txt를 쓸 때 무엇을 조심해야 하나요?
① robots.txt는 숨기기 도구가 아닙니다
구글은 robots.txt가 페이지를 구글에서 빼는 수단이 아니라고 설명합니다. 검색 결과에서 확실히 빼려면 noindex 설정이나 비밀번호 보호를 써야 합니다. 단, 크롤러가 noindex를 읽으려면 그 페이지를 robots.txt로 막지 않아야 합니다.
② 모든 방문이 robots.txt를 따르지는 않습니다
구글은 robots.txt가 크롤러의 행동을 강제할 수 없고, 따를지는 크롤러에 달려 있다고 설명합니다. 사용자 요청형 방문은 성격도 다릅니다. Perplexity는 Perplexity-User가 일반적으로 robots.txt를 따르지 않는다고 밝혔습니다. 민감한 정보는 robots.txt가 아니라 로그인이나 비밀번호로 지켜야 합니다.
③ 한 줄 실수로 전부 막힐 수 있습니다
User-agent: * 아래에 Disallow: /를 쓰면 모든 크롤러에게 사이트 전체를 막는다는 뜻입니다. 개발 중인 사이트를 숨기려고 이렇게 막아뒀다가 정식 오픈 때 그대로 배포하면, 검색과 AI 검색 모두에서 사이트가 빠질 수 있습니다.
다만 특정 크롤러를 따로 허용한 그룹이 있으면 결과가 달라집니다. 구글은 특정 크롤러의 그룹과 * 그룹을 합치지 않고, 해당 크롤러에 가장 구체적으로 맞는 그룹만 적용한다고 설명합니다. 표준을 따르는 크롤러라면 아래 설정에서 OAI-SearchBot은 * 그룹이 아니라 자기 그룹을 적용받습니다.
User-agent: *
Disallow: /

User-agent: OAI-SearchBot
Allow: /
6. 우리 사이트는 지금 어떻게 확인하나요?
개발자가 아니어도 브라우저 주소창만으로 확인할 수 있습니다.
주소창에 우리도메인/robots.txt를 입력해 파일이 있는지 봅니다. 정상적인 404라면 일반적으로 robots.txt에 의한 제한은 없습니다. 서버 오류(5xx)가 나면 구글이 수집을 일시 중단할 수 있으니 먼저 고칩니다.
User-agent: * 또는 Googlebot, OAI-SearchBot, PerplexityBot, Claude-SearchBot 아래에 Disallow: /가 있는지 확인합니다. User-agent: * 아래에 있으면 기본적으로 전체 차단을 뜻하고, 해당 서비스의 검색에서 빠질 수 있습니다. 다만 특정 크롤러를 따로 허용한 그룹이나 경로별 예외가 있는지도 함께 확인합니다.
학습용 크롤러(GPTBot, ClaudeBot, Google-Extended)를 막을지는 회사 방침에 따라 정합니다. 막더라도 검색용 크롤러는 열어둘 수 있습니다.
robots.txt에서 허용해도 실제 접근이 보장되지는 않습니다. CDN, 방화벽, 봇 차단 설정이 막고 있을 수 있어 함께 확인해야 합니다. Perplexity도 WAF를 쓰는 사이트는 자사 봇을 따로 허용하라고 안내합니다.
7. 자주 묻는 질문
Q. AI 학습을 막으면 AI 검색에서도 빠지나요?
회사마다 다릅니다. OpenAI와 Anthropic은 학습용과 검색용 크롤러를 나눠 운영하므로, 학습용만 막고 검색용은 열어두는 설정이 가능합니다. 구글은 Google-Extended를 막아도 구글 검색 노출과 순위에는 영향을 주지 않는다고 밝혔습니다. 다만 Gemini의 학습과 일부 답변 근거 활용에는 영향을 줄 수 있습니다.
Q. robots.txt를 고치면 바로 반영되나요?
바로는 아닙니다. OpenAI는 약 24시간, Perplexity는 최대 24시간이 걸릴 수 있다고 안내합니다. 이 시간은 접근 규칙의 반영에 관한 안내이며, 수정 후 24시간 안에 검색 답변에 나온다는 뜻은 아닙니다.
Q. robots.txt 파일이 아예 없으면 어떻게 되나요?
robots.txt는 막을 곳을 알려주는 파일이라, 정상적인 404라면 일반적으로 robots.txt에 의한 제한은 없습니다. 다만 파일이 없는 것과 서버 오류는 다릅니다. 구글은 robots.txt에서 서버 오류가 나면 처음 12시간 동안 사이트 수집을 멈춘다고 설명합니다. 관리자 페이지처럼 크롤러가 들어올 필요가 없는 곳이 있다면 파일을 만들어 두는 것이 좋습니다.
AI가 들어올 문부터 열어두세요
AI 검색에서 출처로 쓰이려면 먼저 AI의 검색용 크롤러가 우리 사이트에 들어올 수 있어야 합니다. 검색용 크롤러는 열고, 학습용 크롤러는 회사 방침에 따라 정하고, 민감한 정보는 robots.txt가 아니라 로그인으로 지킵니다.
다음 글에서는 문을 열고 들어온 AI가 어떤 글을 믿고 고르는지, 구글이 말하는 E-E-A-T(경험·전문성·권위·신뢰)를 다룹니다.
우리 브랜드, 실제 AI 답변에는 얼마나 나오고 있을까요? 자빈랩에 웹사이트 주소를 넣으면 ChatGPT·Claude·Gemini가 우리 브랜드를 얼마나 언급하는지 확인할 수 있습니다. 자빈랩에서 진단하기