INSIGHTS / AI 마케팅
RAG란 무엇일까? AI가 답을 쓰기 전에 웹부터 검색하는 이유
2026. 10. 29.최원빈
Index
1화의 사장님이 이번에는 스마트폰으로 ChatGPT에 "작은 회사 홈페이지, 어디서 만들면 좋아?"라고 물었다고 해봅시다. 답변 아래에는 출처 링크가 달려 있었고, 그중 하나는 지난번 답변에서 빠졌던 A스튜디오의 '제작 기간 안내' 페이지였습니다.
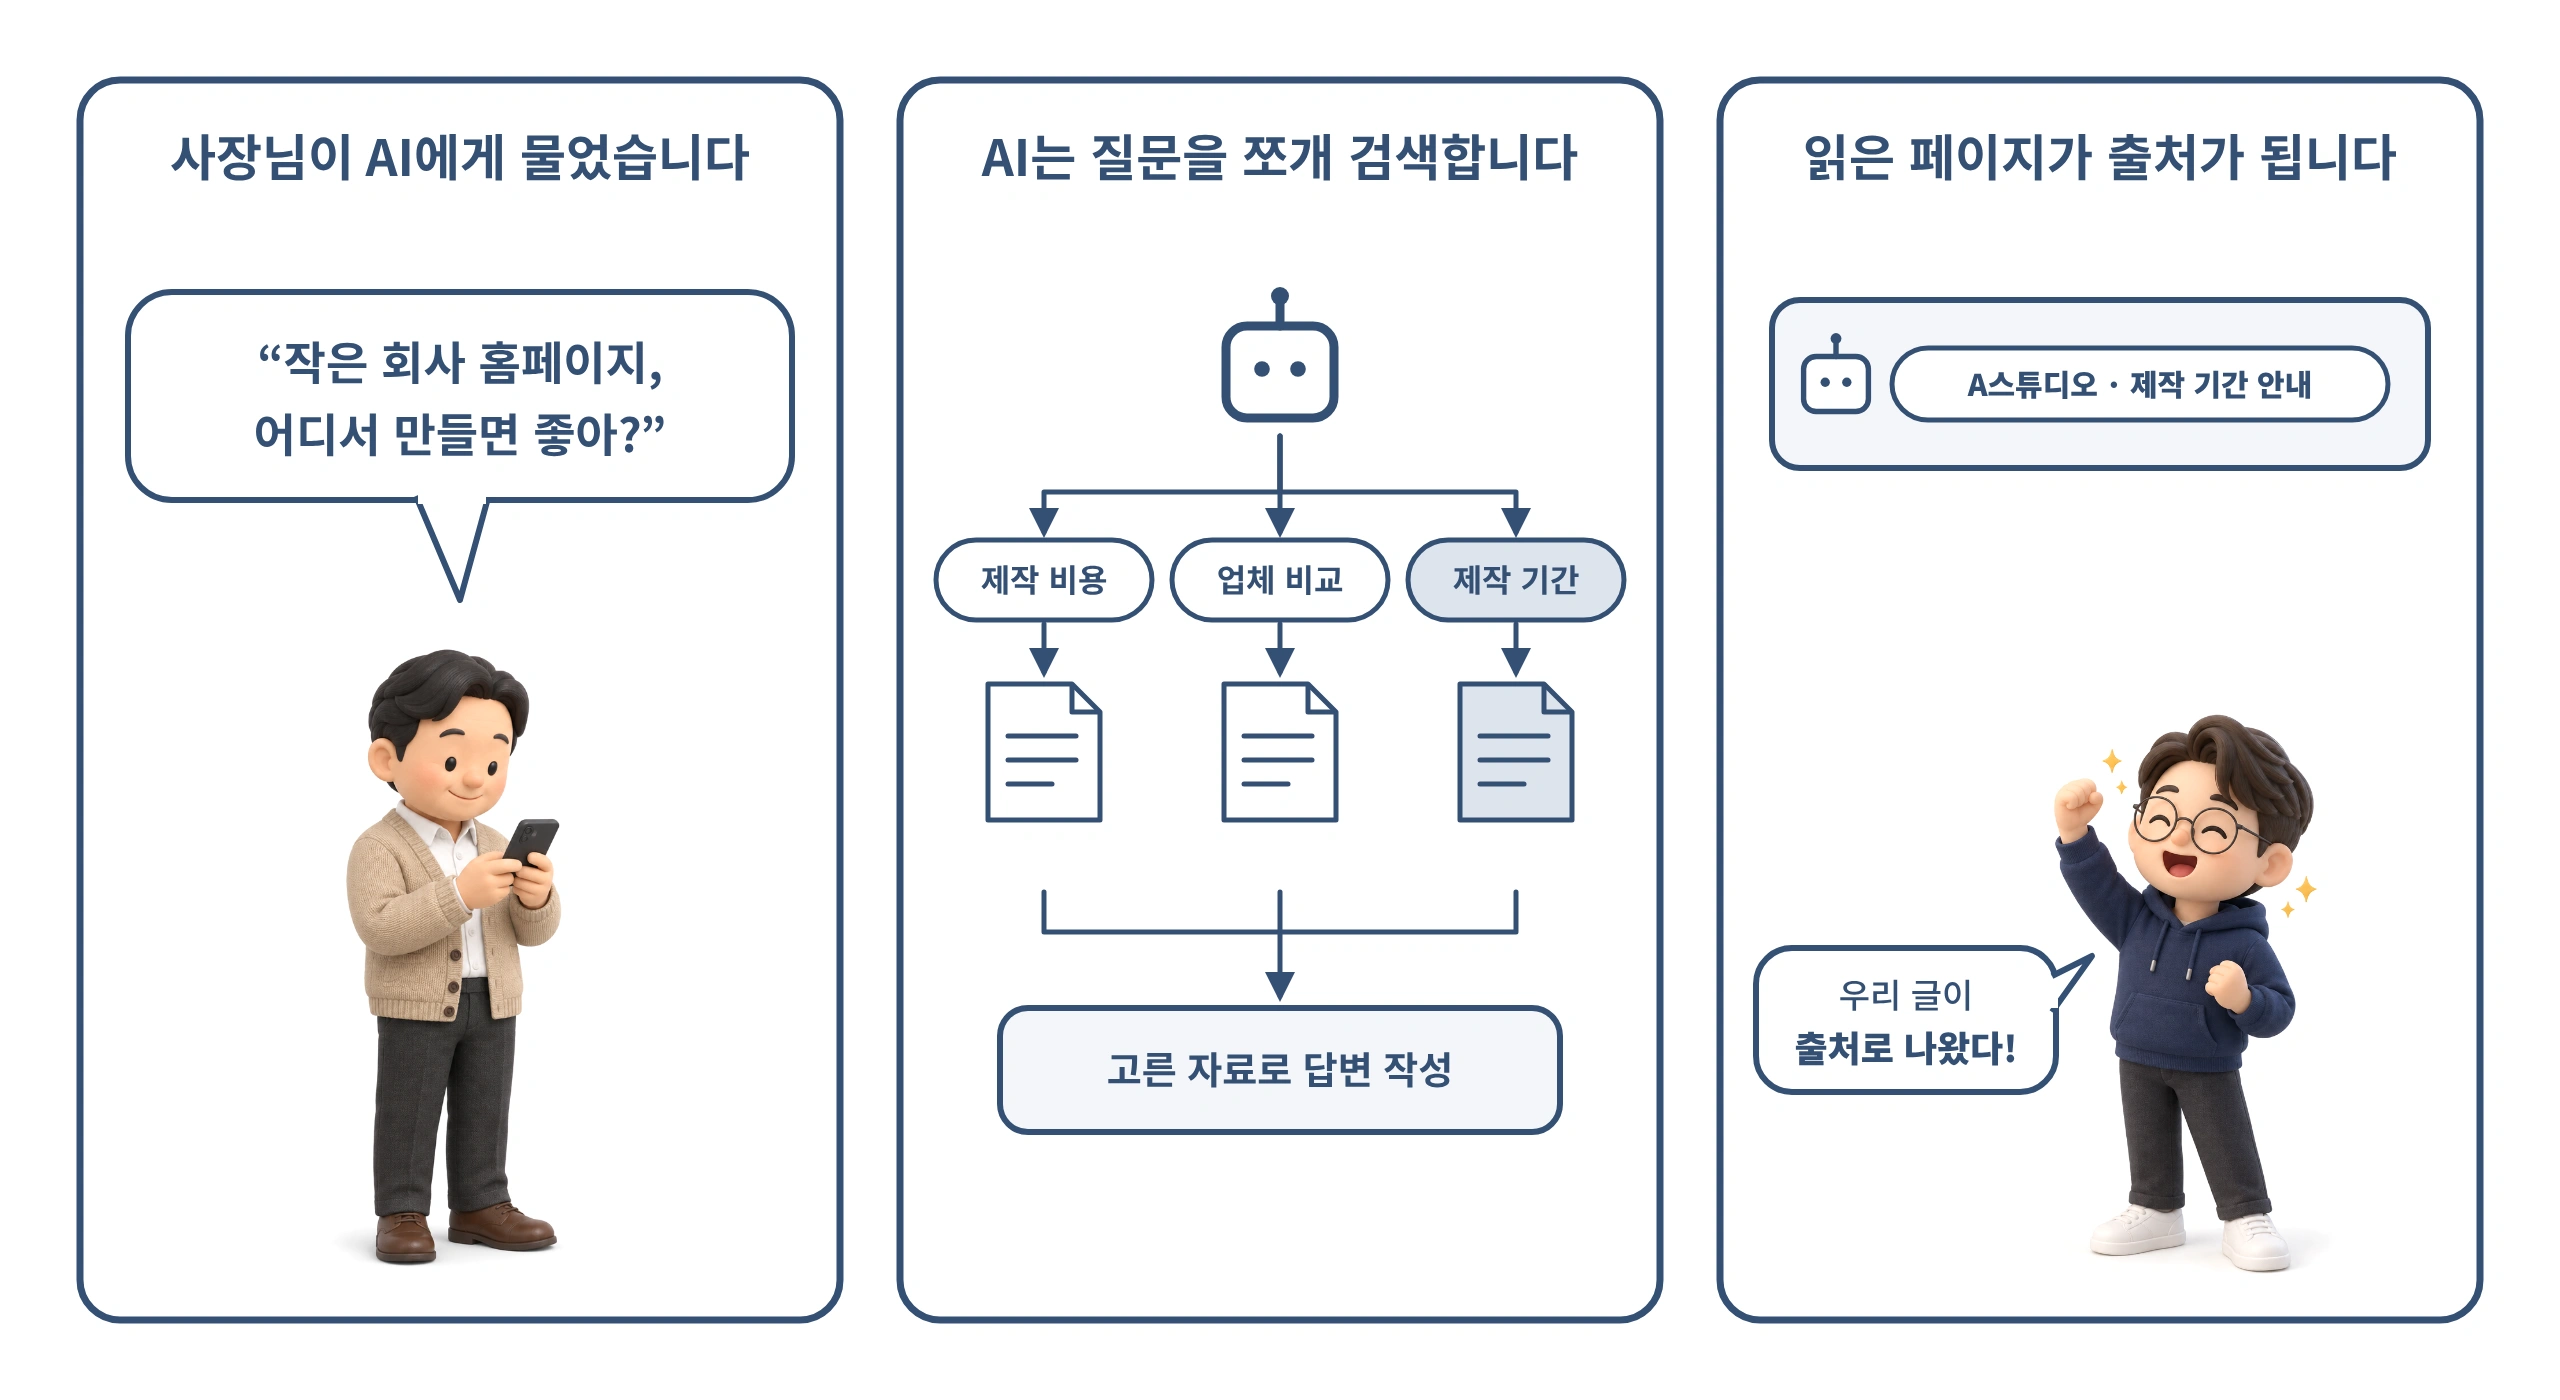
AI는 질문을 쪼개 검색하고, 찾아 읽은 페이지를 출처로 답을 씁니다.
AI는 정해진 시점까지의 자료로 학습합니다. 그런데 어떻게 지금 웹에 있는 페이지를 골라 출처로 보여줄 수 있을까요? 요즘 AI 검색은 답을 쓰기 전에 웹을 검색하고, 찾은 자료를 읽은 뒤 그 자료를 근거로 답을 씁니다. 이 방식을 RAG라고 부릅니다. Retrieval-Augmented Generation, 우리말로 검색 증강 생성입니다.
RAG를 알면 GEO에서 왜 "AI가 우리 사이트를 찾고, 읽고, 믿을 수 있어야 한다"고 말하는지 보입니다. 아래에 RAG를 처음 제안한 논문의 실험 결과, AI가 답을 만드는 4단계, 그리고 단계마다 우리 사이트가 챙길 것을 정리했습니다.
1. AI는 원래 무엇을 알고 있나요?
AI 모델은 학습할 때 읽은 글을 바탕으로 답합니다. 시험으로 치면 책 없이 외운 것만으로 답을 쓰는 암기 시험입니다. 이 방식에는 세 가지 한계가 있습니다.
최신 정보를 모릅니다. 학습이 끝난 뒤에 생긴 일은 알 수 없습니다.
출처를 대기 어렵습니다. 기억에서 꺼낸 내용이라 어디서 읽었는지 보여주기 어렵습니다.
그럴듯하게 틀릴 수 있습니다. 기억이 흐릿한 부분을 그럴듯한 문장으로 채우기도 합니다. 이를 환각(hallucination)이라고 부릅니다.
그런데 지금의 AI 검색은 이 한계를 다른 방법으로 넘습니다. 1화에서 검색 1위 회사가 AI 답변에서 빠질 수 있었던 것도 그 방법 때문입니다.
2. RAG란 무엇인가요?
RAG는 AI가 답을 쓰기 전에 관련 자료를 먼저 찾아 읽고, 그 자료를 근거로 답을 쓰는 방식입니다. 암기 시험이 아니라 책을 펴고 보는 오픈북 시험인 셈입니다.
이 이름은 2020년 Facebook AI Research(현 Meta), 유니버시티 칼리지 런던, 뉴욕대 연구진이 인공지능 학회 NeurIPS에서 발표한 논문에서 붙었습니다. 연구진은 AI가 위키백과 문서를 검색해 참고하게 만들고, 외운 지식만 쓰는 모델과 정답률을 비교했습니다.
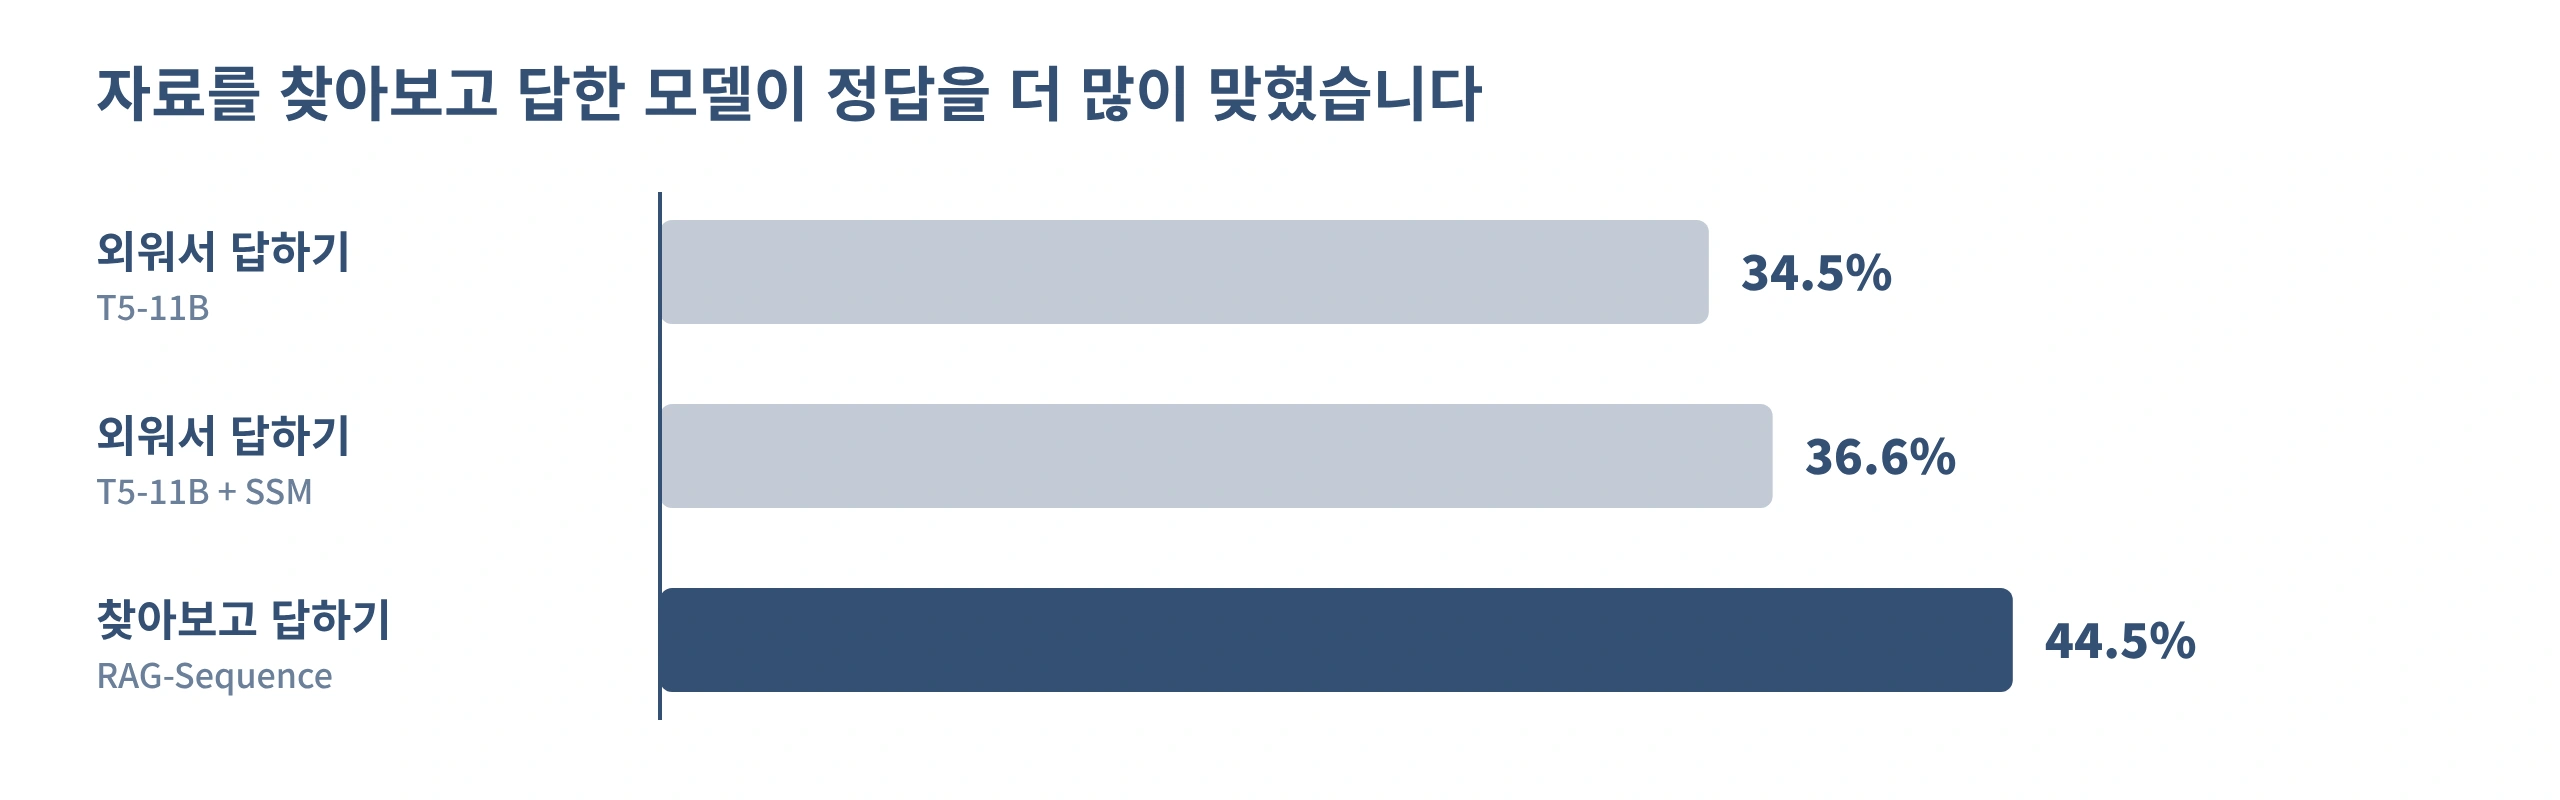
Lewis 외, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (NeurIPS 2020) · 표 1의 Natural Questions 결과
정답률만 오른 게 아닙니다. 퀴즈 문제를 만드는 과제에서 사람이 두 모델의 결과를 비교 평가했을 때, RAG 쪽이 더 사실에 맞다고 본 경우는 42.7%였고 외운 지식만 쓴 모델이 더 낫다고 본 경우는 7.1%였습니다.
구분 | 외워서 답하는 AI | 찾아보고 답하는 AI (RAG) |
|---|---|---|
지식의 출처 | 학습할 때 읽은 내용 | 학습한 내용 + 지금 찾은 자료 |
최신 정보 | 학습 시점까지만 앎 | 검색으로 최신 정보 반영 |
출처 표시 | 어려움 | 읽은 자료를 링크로 보여줌 |
비유 | 암기 시험 | 오픈북 시험 |
지금 우리가 쓰는 AI 검색도 이 방식입니다. OpenAI는 2024년 10월 ChatGPT 검색을 공개하면서, ChatGPT가 질문을 보고 웹 검색 여부를 스스로 정하고 답변에 출처 링크를 단다고 설명했습니다.
3. AI는 어떤 순서로 답을 만드나요?
서비스마다 세부 방식은 다르지만, 큰 흐름은 질문 이해 → 검색 → 고르고 읽기 → 답변 쓰기의 4단계입니다.
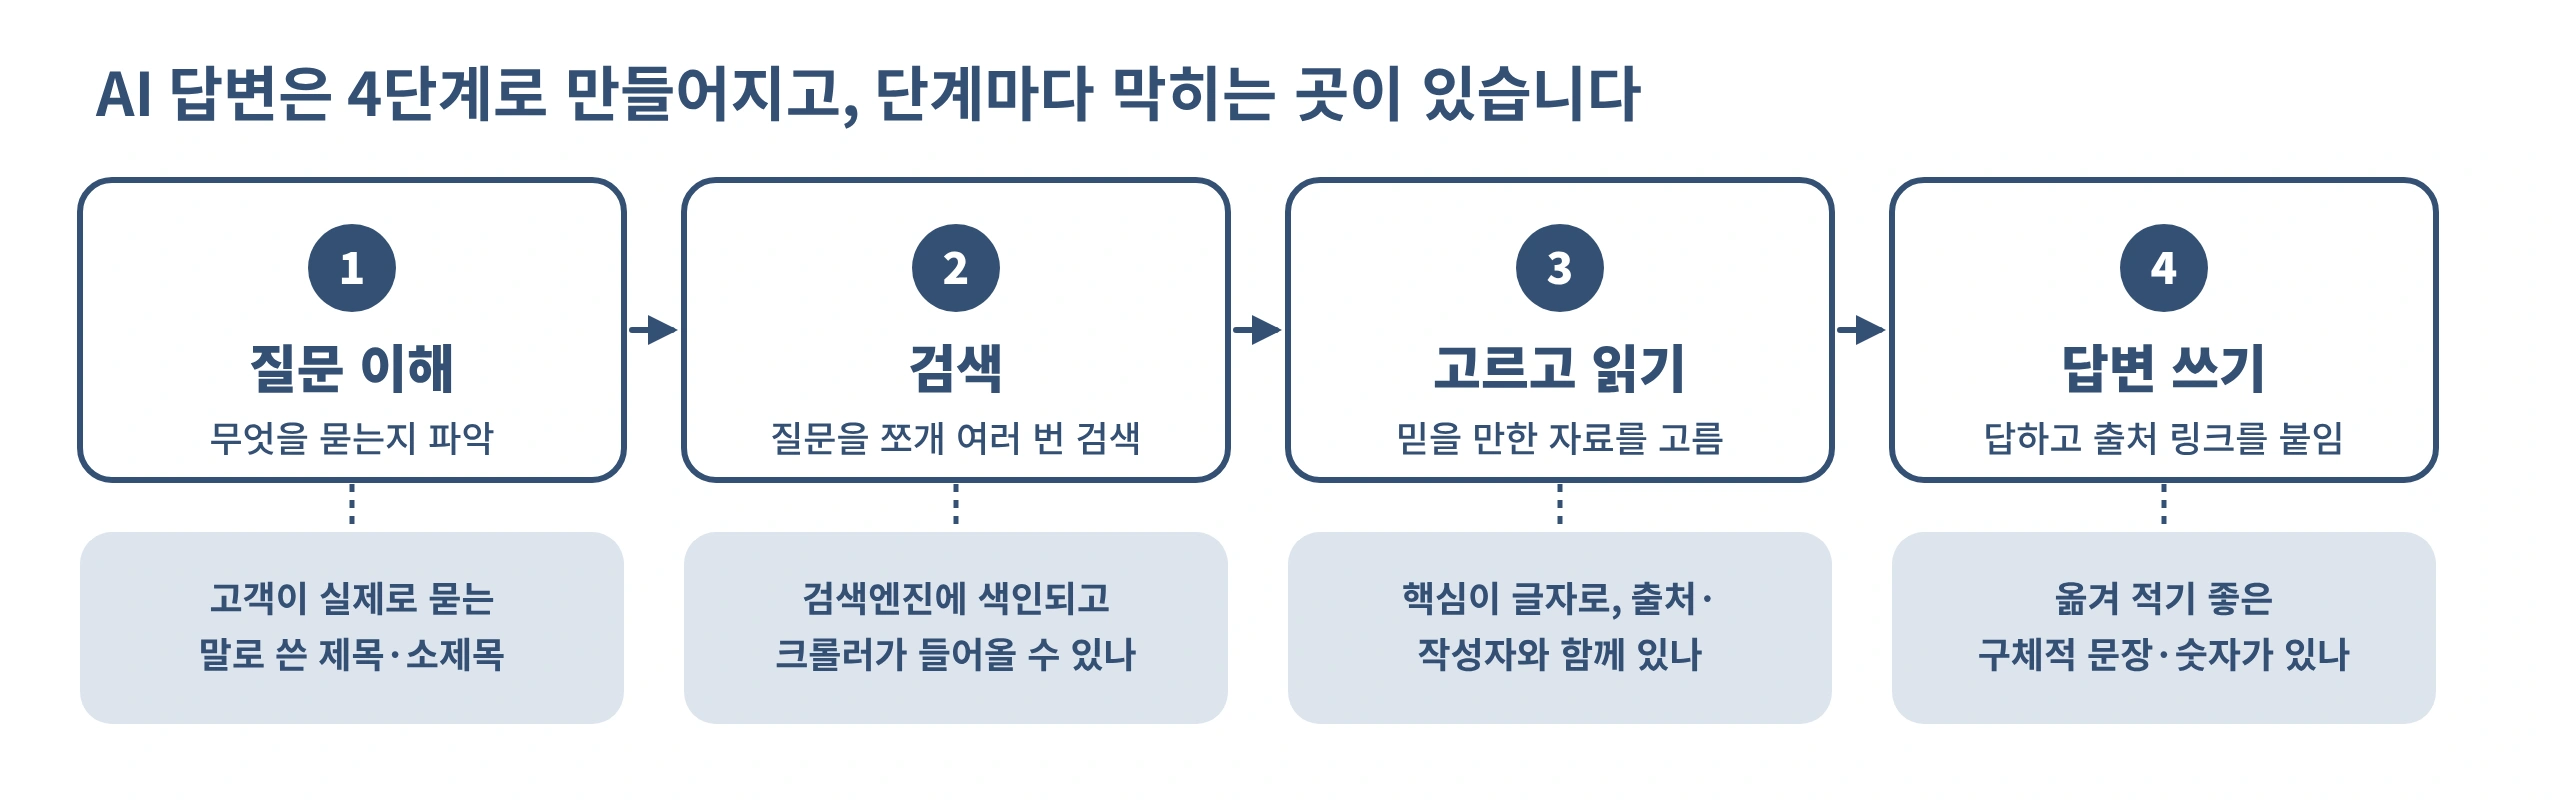
① 질문 이해하기
사용자가 무엇을 묻는지, 검색이 필요한 질문인지 판단합니다.
② 검색하기
질문과 관련된 자료를 웹에서 찾습니다. 한 번만 찾지 않습니다. 구글은 AI 개요와 AI 모드가 질문 하나를 여러 세부 주제로 나눠 동시에 검색하는 쿼리 팬아웃(query fan-out)을 쓸 수 있다고 안내합니다.
"작은 회사 홈페이지 어디서 만들어?"라는 질문 하나가 "제작 비용", "업체 비교", "제작 기간" 같은 여러 검색으로 나뉘는 식입니다.
복잡한 질문 하나가 뒤에서 8~20번 넘는 검색을 일으킬 수 있다고 추정합니다. 다만 구글은 정확한 횟수를 공개하지 않았습니다.
③ 고르고 읽기
찾은 자료 가운데 질문에 맞고 믿을 만한 것을 골라 내용을 뽑아냅니다.
④ 답변 쓰기
읽은 내용을 바탕으로 답을 정리하고, 참고한 자료를 출처 링크로 붙입니다.
4. AI는 질문할 때마다 검색하나요?
아닙니다. 하지만 업체를 찾고 비교하는 질문일수록 검색을 거칠 가능성이 큽니다.
Graphite가 2026년 7~8월 로그인하지 않은 ChatGPT의 답변을 분석해보니, 여러 대상을 비교하는 정보형 질문에서는 답변의 약 58%에 검색 흔적이 있었습니다. 반면 질문 종류를 가리지 않고 보면, 미국 ChatGPT 답변 중 출처가 달린 비율은 7%라는 Similarweb 집계도 함께 소개했습니다.
인사말이나 글 다듬기처럼 검색이 필요 없는 질문은 외운 지식으로 답합니다. 반대로 "어디가 좋아?", "얼마야?", "뭐가 달라?"처럼 고객이 업체를 고를 때 하는 질문은 검색을 거쳐 답할 때가 많습니다. GEO가 노리는 곳이 바로 이 검색을 거치는 질문입니다.
5. 그래서 우리 사이트는 무엇을 준비해야 하나요?
AI가 펼쳐보는 책 안에 우리 페이지가 있어야 하고, 그 페이지가 AI가 쪼갠 세부 질문에 답하고 있어야 합니다.
구글은 AI 개요와 AI 모드의 출처 링크로 나오려면 페이지가 검색에 색인돼 있고, 검색 결과에 요약문과 함께 표시될 수 있어야 한다고 안내합니다. 그 밖에 AI만을 위한 별도 요건은 없다고 밝혔습니다. 출발점은 결국 검색에 잘 걸리는 사이트입니다.
그 위에서 팬아웃을 생각하면 할 일이 구체적으로 보입니다.
서비스 페이지 하나에 고객이 함께 묻는 질문을 모읍니다. 비용, 진행 기간, 작업 범위, 다른 방식과의 차이를 각각 단락으로 답합니다.
소제목만 읽어도 무엇에 답하는지 알게 씁니다. 그 단락만 떼어 읽어도 이해되게 만들면 AI가 그대로 옮겨 적기 쉽습니다.
비교 글을 만듭니다. "템플릿 제작 vs 맞춤 제작"처럼 고객이 실제로 고민하는 비교는 팬아웃에서 자주 나오는 세부 질문입니다.
가격과 범위가 바뀌면 바로 고칩니다. AI는 지금 웹에 있는 내용을 읽습니다.
6. 자주 묻는 질문
Q. AI 학습 데이터에 우리 회사가 없으면 끝인가요?
그렇지 않습니다. RAG 방식에서는 AI가 답할 때 지금 웹에 있는 자료를 찾아 읽습니다. 학습 데이터에 없던 회사라도 웹사이트와 외부 자료가 잘 갖춰져 있으면 답변에 쓰일 수 있습니다.
Q. AI 검색에 나오려면 특별한 파일이나 코드가 필요한가요?
구글 기준으로는 필요 없습니다. 구글은 AI 개요와 AI 모드를 위해 AI 전용 파일이나 새로운 마크업을 만들 필요가 없다고 안내합니다. 다만 ChatGPT, 퍼플렉시티 같은 다른 서비스는 방식이 다를 수 있습니다.
Q. 팬아웃 검색어를 하나하나 맞춰서 써야 하나요?
아닙니다. AI가 만드는 세부 검색어는 실행할 때마다 달라지고, 실제 검색량이 거의 없는 경우가 많습니다. 정확한 문구보다 고객이 반복해서 궁금해하는 내용을 찾아 답해두는 것이 맞습니다.
결론적으로, AI 검색은 오픈북 시험입니다
요즘 AI는 외운 것만으로 답하지 않습니다. 질문을 쪼개 웹을 검색하고, 찾아 읽은 페이지를 근거로 답을 씁니다. 우리 브랜드가 그 답에 들어가려면 AI가 펼쳐보는 책 안에 우리 페이지가 있어야 하고, 그 페이지가 고객의 세부 질문에 답하고 있어야 합니다.
다음 글에서는 AI가 그 책을 모으는 방법, AI 크롤러를 다룹니다. GPTBot 같은 AI 크롤러가 무엇인지, robots.txt로 어떻게 열고 막는지 정리합니다.
우리 사이트, AI가 찾고 읽을 수 있을까요? 자빈랩에 웹사이트 주소를 넣으면 ChatGPT·Claude·Gemini가 우리 브랜드를 얼마나 언급하는지 확인할 수 있습니다. 자빈랩에서 진단하기